Generative Engine Optimization
AI-crawlers blokkeren of toestaan: zo maak je de goede keuze
Wat zijn AI-crawlers en wat kies je: blokkeren of toestaan? Wat training, zoeken en ophalen betekenen, met de nieuwe regels van Google en Bing.
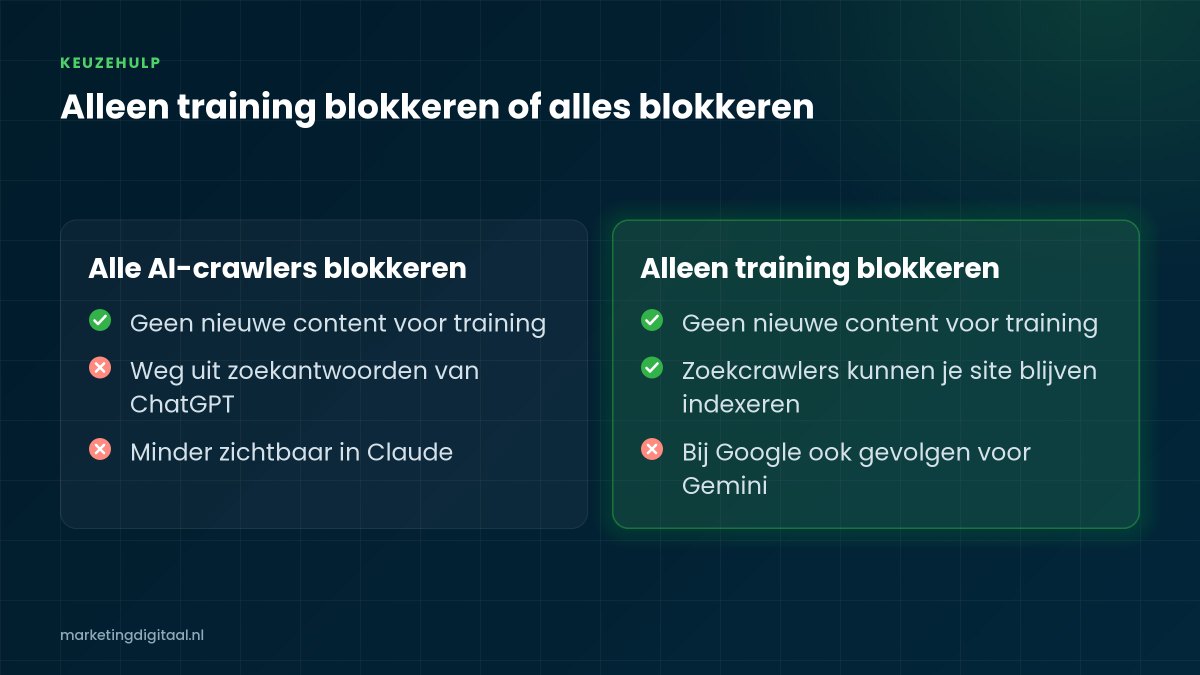
Kort antwoord: AI-crawlers kun je het beste per doel beoordelen in plaats van allemaal tegelijk te blokkeren. Blokkeer je crawlers voor AI-training, dan blijf je meestal zichtbaar in AI-zoekfuncties. Blokkeer je zoekcrawlers zoals OAI-SearchBot, dan verdwijn je juist uit de zoekantwoorden van die dienst, en de keuze bij Google vraagt extra aandacht.
Deze keuze wordt nu actueel. Op 30 oktober 2026 meldde Google dat het een gedeelde instelling voor AI-training wil ondersteunen, en dezelfde dag kwam Microsoft Bing met nieuwe AI-voorkeuren. We schreven al een nieuwsbericht over die gedeelde regel. In dit artikel lees je wat je er als ondernemer of marketeer mee moet.
Wat zijn AI-crawlers?
Een AI-crawler is een geautomatiseerd programma dat webpagina’s ophaalt voor een AI-dienst, bijvoorbeeld om modellen te trainen of om vragen van gebruikers te beantwoorden. Het belangrijkste onderscheid zit in dat doel, want elk type crawler heeft een ander gevolg als je het blokkeert.
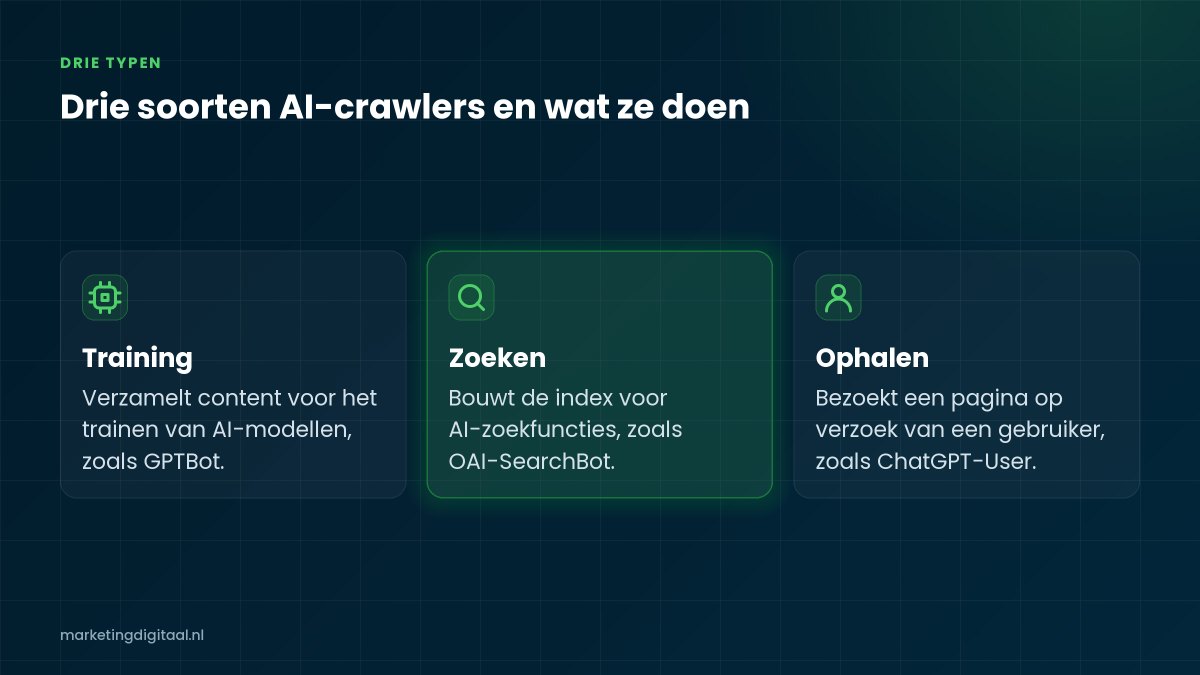
Welke drie soorten crawlers zijn er?
- Trainingscrawlers verzamelen content die kan worden gebruikt om AI-modellen te trainen. Voorbeelden zijn GPTBot van OpenAI en ClaudeBot van Anthropic.
- Zoekcrawlers bouwen de index waaruit AI-zoekfuncties putten. Voorbeelden zijn OAI-SearchBot en Claude-SearchBot.
- Ophaalcrawlers bezoeken een pagina omdat een gebruiker daar op dat moment om vraagt. Voorbeelden zijn ChatGPT-User en Claude-User.
OpenAI stelt dat de instellingen per crawler los van elkaar werken. Je kunt OAI-SearchBot dus toelaten en GPTBot blokkeren. Blokkeer je OAI-SearchBot, dan verschijnt je site niet meer in de zoekantwoorden van ChatGPT, al kan een navigatielink nog wel voorkomen. Anthropic beschrijft eenzelfde verdeling: het blokkeren van Claude-SearchBot of Claude-User kan je zichtbaarheid in de antwoorden van Claude verlagen.
Wat regelt robots.txt wel en niet?
Robots.txt is een verzoek aan crawlers, geen slot op de deur. Gary Illyes en Cherry Prommawin van Google legden in oktober 2026 uit dat het bestand aangeeft welke pagina’s een crawler mag ophalen, maar niet bepaalt wat een bedrijf daarna met de content doet. Het is dus ook geen beveiliging.
Daar komen twee beperkingen bij. Ten eerste geldt voor ChatGPT-User volgens OpenAI dat robots.txt-regels mogelijk niet van toepassing zijn, omdat een gebruiker het bezoek start. In haar uitgebreide naslagwerk schrijft zoekspecialist Vanessa Fox dat de meeste ophaalcrawlers robots.txt negeren en dat je ze alleen op server- of CDN-niveau tegenhoudt. Claude-User en DuckAssistBot noemt ze als uitzonderingen. Ten tweede geldt een blokkade alleen vooruit: het blokkeren van ClaudeBot gaat volgens Anthropic om toekomstig materiaal.
Ook de praktijk is minder zwart-wit dan je zou denken. BuzzStream analyseerde ongeveer 4 miljoen AI-citaties en keek daarbij naar 50 grote nieuwssites. Van de sites die ChatGPT-User blokkeerden werd 70,6 procent toch geciteerd. Dat is een correlatie bij grote nieuwsmerken en de oorzaak is onbekend, dus trek er voor een mkb-site geen harde conclusies uit.
Nieuwsbrief
Meer van dit soort updates in je inbox?
Meld je aan voor de nieuwsbrief van Marketing Digitaal. Gratis, en afmelden kan altijd.
We gebruiken je naam en e-mailadres alleen voor de nieuwsbrief. Lees ons privacybeleid.
Wat verandert er door de nieuwe AI-instellingen?
Hoe werkt het gedeelde signaal voor AI-training?
Het signaal heet __usage_ai-training en je zet het als eigen groep in robots.txt. Je geeft daarmee in één keer een voorkeur over AI-training aan, in plaats van elke aanbieder los te noemen. Volgens het concept van Kevin Kelley van Anthropic ziet dat er zo uit, met elke regel apart in het bestand:
- User-agent: __usage_ai-training
- Disallow: /
- Allow: /press-kit/
Dit voorbeeld zegt: gebruik niets voor AI-training, behalve de perskit. Let op drie dingen:
- Het is nog geen standaard. Het gaat om een individueel concept zonder formele status bij de Internet Engineering Task Force. Betrokkene Nate Hake meldt dat er “significant areas of dispute” overblijven.
- Het werkt nog niet overal. Google mikt op begin 2027 en Microsoft op 1 februari 2027. OpenAI noemt volgens Fox de komende maanden en Anthropic is met de invoering begonnen, zonder datum.
- Een algemene groep telt niet mee. Een regel onder User-agent: * geldt niet voor dit signaal. Je moet het apart noemen, en het blokkeert het crawlen zelf niet.
Wat is de valkuil bij Google?
Gebruik je het signaal om training uit te sluiten en noem je Google-Extended niet apart, dan behandelt Google dat alsof je Google-Extended blokkeert. Dat lijkt logisch, maar Google-Extended regelt twee dingen: training van toekomstige Gemini-modellen én grounding in de Gemini-apps en Vertex AI. Grounding betekent dat een model op het moment van de vraag actuele content uit de index krijgt om zijn antwoord op te baseren.
Sluit je training uit, dan kun je dus ook zichtbaarheid in Gemini verliezen. Wil je dat niet, dan kun je volgens Fox Google-Extended apart toestaan, omdat de eigen regel van een bedrijf voor de gedeelde regel gaat. Die keuze staat dan wel training door Google toe. Google-Extended heeft volgens Google geen invloed op opname of ranking in Google Search.
Hoe regel je AI Overviews en AI Mode?
Daarvoor heb je een andere knop nodig. Sinds 31 augustus 2026 staat de Search generative AI-instelling wereldwijd in Google Search Console, onder Instellingen. Kies je Exclude, dan blijft je site uit AI Overviews, AI Mode en de AI-functies in Discover. Google zegt dat de instelling geen rankingsignaal is voor de rest van Search en geen invloed heeft op AI-training. Je mist dan wel alle verkeer en vertoningen uit die functies. In het AI-rapport van Search Console kun je eerst bekijken hoe vaak je daar verschijnt.
Wat doet Microsoft Bing?
Microsoft splitst training en grounding. Training stel je in via robots.txt of per pagina, grounding alleen per pagina via een metatag of X-Robots-Tag-header. Bij grounding kun je kiezen uit Allow, DisallowExtended (alleen Microsofts eigen diensten zoals Copilot) en Disallow. Vanaf 1 februari 2027 leest Bing de nieuwe voorkeuren tijdens het crawlen. Gebruik je nu NoArchive of NoCache om AI-gebruik te beperken? Na 1 maart 2027 tellen die daarvoor niet meer mee, dus zet je voorkeuren voor die datum over. Blokkeer je grounding, dan daalt je zichtbaarheid in AI-ervaringen volgens Microsoft.
Wat is de beste keuze voor jouw website?
Dat hangt af van hoe je geld verdient. Dit is onze inschatting, geen vaste regel en geen juridisch advies:
- Dienstverlener of lokaal bedrijf: laat zoek- en ophaalcrawlers toe. Je wilt juist genoemd worden als iemand een aanbieder zoekt, en dat past bij Generative Engine Optimization (GEO). Training blokkeren heeft voor jou weinig haast, maar kan wel als je dat principieel wilt.
- Webshop: houd zoekcrawlers open voor productpagina’s en denk na over training van unieke teksten en beelden.
- Uitgever of kennisbedrijf: blokkeer training eerder, want je content is je product. Test zoekcrawlers per sectie, bijvoorbeeld open voor gratis artikelen en dicht voor betaalde inhoud.
Je bent daarin niet alleen. In de analyse van TechnologyChecker van 4.242 robots.txt-bestanden uit Cloudflare Radar wordt GPTBot 1,6 keer zo vaak geblokkeerd als toegestaan, terwijl OAI-SearchBot ongeveer even vaak wordt toegestaan als geblokkeerd. Het gaat alleen om bestanden die de crawler noemen, dus niet om het hele web.
Zo pak je het aan
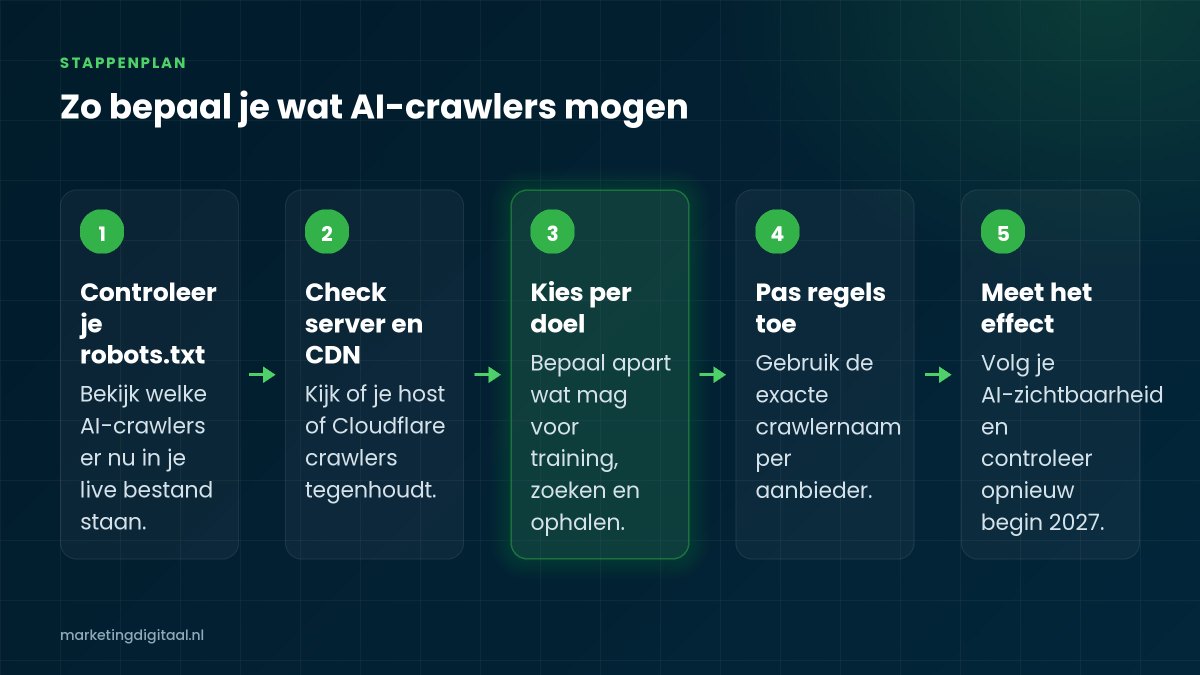
- Bekijk je live robots.txt. Open jouwdomein.nl/robots.txt en controleer welke AI-crawlers er al in staan. Kijk naar de live versie, niet naar een kopie in je CMS.
- Check je server en CDN. Fox waarschuwt dat sommige hosts AI-crawlers standaard blokkeren, ook als robots.txt alles toestaat. In Cloudflare kan de optie Block voor AI-training volgens haar ook zoekcrawlers zoals Googlebot raken. Controleer die instelling goed.
- Test met echte verzoeken. Een robots.txt-checker ziet geen blokkade op de server. Bekijk je serverlogs om te zien welke crawlers binnenkomen en welke antwoorden ze krijgen. Herhaal de test bij een 429-melding, want dat is niet altijd een blokkade.
- Leg je keuze per doel vast. Bepaal apart wat je wilt voor training, AI-zoeken en ophalen, en voor welke delen van je site.
- Pas de regels toe. Noem elke crawler bij zijn exacte naam, want Google waarschuwt dat onbekende regels worden genegeerd. Wie training wil uitsluiten, gebruikt nu de eigen regels van elke aanbieder en kan het gedeelde signaal toevoegen.
- Meet het effect. Volg je zichtbaarheid in Search Console en Bing Webmaster Tools, en plan een controle rond 1 februari en 1 maart 2027.
Twijfel je over de gevolgen voor je vindbaarheid? Bij onze dienst Generative Engine Optimization nemen we deze keuzes mee in een plan voor je zichtbaarheid in AI.
Veelgestelde vragen
Wat is het verschil tussen GPTBot en OAI-SearchBot?
GPTBot haalt content op die kan worden gebruikt om AI-modellen van OpenAI te trainen. OAI-SearchBot zorgt ervoor dat je site in de zoekfuncties van ChatGPT kan verschijnen. Je kunt ze los van elkaar instellen.
Verdwijn ik uit Google als ik Google-Extended blokkeer?
Nee. Google-Extended heeft volgens Google geen invloed op je opname of ranking in Google Search. Het kan wel je zichtbaarheid in de Gemini-apps en Vertex AI beperken.
Kan ik uit AI Overviews blijven zonder gewone rankings te verliezen?
Ja, met de Search generative AI-instelling in Search Console. Google zegt dat die geen rankingsignaal is voor de rest van Search. Je krijgt dan geen verkeer of vertoningen meer uit AI Overviews en AI Mode.
Werkt __usage_ai-training nu al?
Nog niet volledig. Google wil het begin 2027 ondersteunen en Microsoft vanaf 1 februari 2027. Volgens Vanessa Fox kan toevoegen geen kwaad, maar wil je training nu al beperken, gebruik dan ook de eigen regels van elke aanbieder.
Is robots.txt genoeg om AI-crawlers tegen te houden?
Niet altijd. Robots.txt is een verzoek dat nette crawlers volgen, geen beveiliging. Wil je een crawler echt weren, dan heb je een blokkade op server- of CDN-niveau nodig.
Conclusie
AI-crawlers blokkeren is geen kwestie van alles aan of alles uit. Training, zoeken en ophalen hebben elk hun eigen gevolgen, en Google en Microsoft geven je daar binnenkort meer knoppen voor. Voor de meeste bedrijven is het logisch om zoekcrawlers open te houden en alleen bewust over training te beslissen. Controleer nu je huidige instellingen, want een blokkade bij je host of CDN kan je zichtbaarheid al raken zonder dat je het weet.
Meer artikelen
Ook interessant
Google AI-modus: zo word je er als bron in genoemd
De Google AI-modus kiest zelf welke websites hij noemt. Lees hoe hij bronnen selecteert, wat Gemini 4 Hydrogen verandert en hoe je zichtbaar wordt.
- AI Overviews
- Gemini
- Generative Engine Optimization
AI-verkeer meten in GA4: zo zie je wat ChatGPT oplevert
AI-verkeer meten in GA4 lukt deels: het kanaal AI Assistant toont ChatGPT en Gemini, maar mist AI Overviews en apps. Zo maak je het beeld compleet.
- AI-verkeer
- Bing Webmaster Tools
- ChatGPT
Lokale SEO in AI: zo word je aanbevolen in ChatGPT
Lokale SEO werkt in AI anders dan in Google Maps. Lees welke bronnen ChatGPT en Google AI gebruiken en hoe je als lokaal bedrijf vaker genoemd wordt.
- AI Overviews
- ChatGPT
- Generative Engine Optimization
Nieuwsbrief
Meer van dit soort artikelen?
Ontvang de nieuwste artikelen, trends en praktische tips over online marketing in je inbox. Gratis, en afmelden kan altijd.
We gebruiken je naam en e-mailadres alleen voor de nieuwsbrief. Lees ons privacybeleid.
Vragen over dit onderwerp?
Wat betekent dit voor jouw bedrijf?
Stel je vraag aan onze specialisten. Een kennismaking is gratis en vrijblijvend.
